讓打磚塊 DQN 從遊戲畫面走到瀏覽器
從遊戲畫面、DQN 訓練與模型比較,到 ONNX 推論和瀏覽器展示,完整介紹打磚塊專案。
文章目錄
這個專案的終點是一個網頁:左邊你自己玩打磚塊,右邊一個 AI 同時玩它自己的那一局。AI 是從零訓練出來的 DQN,沒有人教它規則。
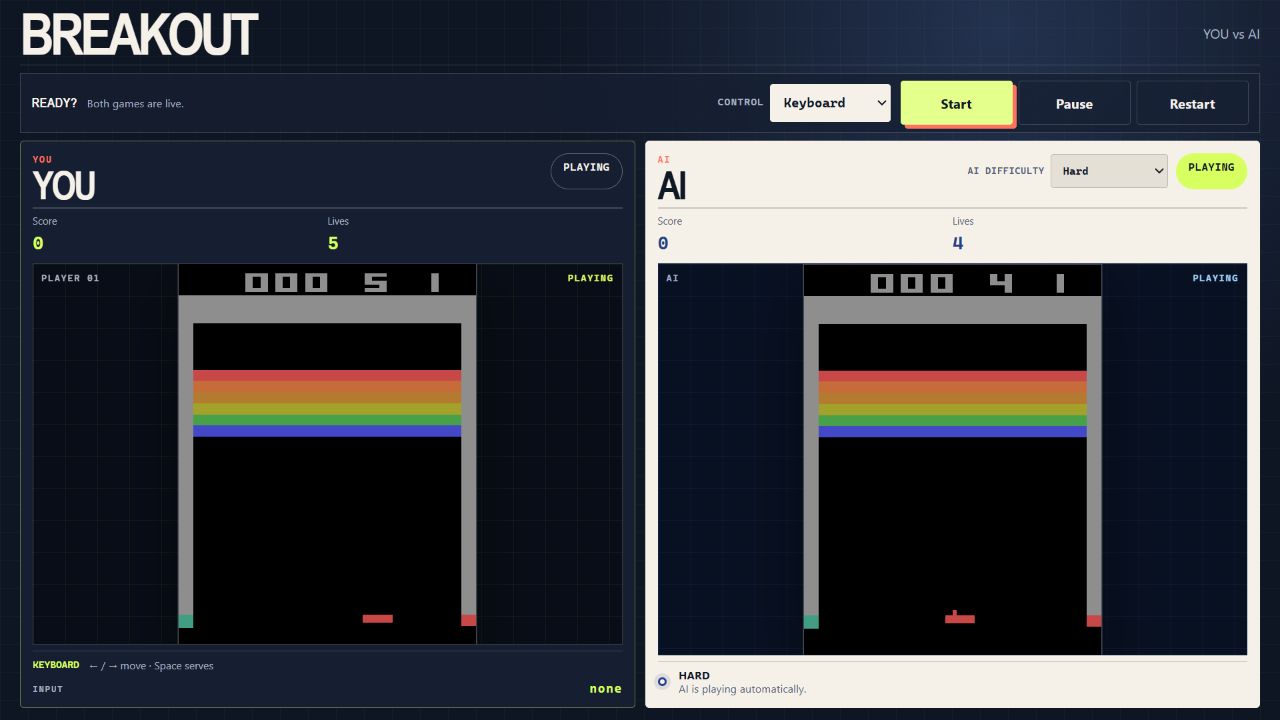
最後的成果:人和 AI 並排,各玩各的一局,球、磚塊和命數都不共用。
走到這一步花了三十天。最花時間的不是訓練,而是確認每一個分數到底在說什麼。
模型看到的是一疊數字
人看打磚塊,看到的是球在飛。模型每一步只收到一組數字,而且單看一張畫面,分不出球正往哪個方向飛。
所以模型每次同時看最近四張畫面,再從不動、發球、往右、往左裡挑一個。DQN 做的事,就是替這四個動作各估一個分數,估的是「現在按這個鍵,之後大概能拿多少分」。
- 遊戲畫面 210×160 彩色
- 縮小並轉灰階 84×84
- 疊最近 4 張 看得出球往哪飛、飛多快
- 選分數最高的動作 不動、發球、往右、往左
每次操作推進幾張畫面、掉命後怎麼重新發球、遊戲何時結束,都會改變模型經歷到的遊戲。這些規則先固定下來,之後兩個版本的分數才能放在一起比。
平均分贏了,模型卻沒在玩
第一次正式評估,我讓模型和一個隨機亂按的對手各玩 15 局。模型平均 4.53 分,亂按只有 1.33 分。
另一個數字不對勁。亂按每局平均撐 186 步,模型卻平均走了 18,131 步。
15 局裡有 10 局停在 27,000 步附近,那正是遊戲的時間上限。模型撐得久,是因為遊戲根本沒在進行。
攤開其中一局:第 54 步掉了一條命,下一次按發球是第 16,449 步。這中間畫面停在等待發球的狀態,模型一直看到同一個畫面,就一直把球拍往右推。
訓練時沒發現,是因為訓練中有 5% 的機率隨機按鍵,偶爾會碰巧按到發球。評估時拿掉隨機性,問題才露出來。
為了確認是發球的問題,我只改「誰負責發球」,其他條件不動。
發球交給遊戲環境後,平均分變成 8.80,沒有一局卡住。從此開局和掉命後的發球都由環境處理,訓練和評估用同一套規則。
這件事改變了之後看數字的方式:平均分要和每局實際發生的事一起看。
練得更快,不等於練得更好
接下來處理速度。同時跑兩場遊戲,每秒收集的經驗從 238.67 筆提高到 380.74 筆,約快 1.6 倍。
但這次練出來的模型,分數沒有跟著提高。速度決定多快拿到經驗,不決定學得多好。
我接著比較三種 DQN,每種獨立訓練三次、各練 50 萬步。結構最複雜的一種平均 20.178 分,高於最基本的 15.844 分,代價是更多計算。
選定的那一種繼續往下練,成績如下。
50 萬、100 萬步是三次訓練的平均;250 萬、500 萬步是選定的那一次訓練;最右欄是同一個 250 萬步模型換新起點重新驗收。
500 萬步比 250 萬步還低,所以最後採用 250 萬步的模型。最右邊那一欄最值得記住:換一組沒用來挑模型的新起點,平均分從 51.4 掉到 30.933。
挑模型時看到的高分,有一部分來自「挑」這個動作本身。最終成績要用沒參與挑選的局來量。
搬到瀏覽器,還是同一個模型嗎
訓練好的模型要先轉成一種通用格式,其他程式才讀得懂。讀得懂不代表行為一樣,所以我準備了 60 張固定畫面,讓轉換前後的模型各算一次。
- 轉成通用格式後,固定畫面上選到相同動作
- 60/60
- 放進瀏覽器後,同一批畫面選到相同動作
- 60/60
60 張全部選到相同動作。換用顯示卡專用的執行方式後,較慢那一端的等待時間也降了下來。
進到瀏覽器,畫面縮小、動作對應和掉命後的發球都要照訓練時的規則重做一次。同一批 60 張畫面在瀏覽器裡再比一次,動作仍然全部一致。
速度也量了。在瀏覽器裡用處理器算一次決策,中位數是 0.995 毫秒;用顯示卡反而要 3.985 毫秒,因為模型很小,搬資料比計算還花時間。
所以網頁預設用處理器跑模型。
網頁裡跑的這個模型放在 Hugging Face,是整個專案唯一開放下載的模型。
huggingface.co 下載模型:Breakout Dueling Double DQN 部署在網頁版的神經網路,也是唯一公開的模型:原始的 PyTorch checkpoint(model.pt)和瀏覽器執行的 ONNX 檔(model.onnx)。回頭看這三十天
這條路把遊戲規則、訓練、逐局評估和瀏覽器部署接成一條線。每一段最後都回到同一個問題:這個數字量到的,是不是我以為的那件事。
延伸閱讀
上面每一段都有一篇完整的文章。前兩段的文章和一篇獨立實驗列在下方的相關文章,後三段照順序是:
- 訓練更快,DQN 就更好嗎? 速度、三種 DQN 與重新驗收
- 模型換了執行方式,DQN 還會做出相同選擇嗎? 60 張固定畫面的比對
- 把 DQN 放進瀏覽器後,還能像訓練時一樣玩嗎? 瀏覽器裡的部署
想直接看結果,到打磚塊網頁版和 AI 各玩一局。