AI 怎麼從 Breakout 畫面學會選動作?
從打磚塊的一次互動開始,理解模型看到的畫面、即時得分與未來價值,並看 Q-Learning 如何把未來的回饋傳回現在。
文章目錄
球在畫面上,球拍也在畫面上,模型為什麼還需要學習?因為一張截圖只能告訴它球在哪裡,卻不容易看出球正往哪個方向移動。要讓它學會選動作,我們得先弄清楚:遊戲每一步回傳什麼、模型究竟看見什麼,以及現在的動作如何影響之後的分數。
一次操作會帶回什麼?
可以把 Agent 想成坐在遊戲旁的玩家:先看一眼畫面,選擇一個動作;遊戲執行後,再告訴它畫面如何改變、這一步得了幾分,以及這局是否結束。
這一步得到的即時分數稱為 reward。遊戲本身結束,和測試時間到了而被迫停止,是兩種不同情況:前者真的沒有下一步,後者則可能只是計時器到期。模型要不要繼續估計未來,會受到這個差異影響。
如果資料把「動作之前看到的畫面」和「動作之後的結果」接錯,模型收到的就像是錯誤的遊戲教學。於是,即使程式正常執行,學習目標仍可能沒有意義。
為什麼一張畫面不夠?
同一個球的位置,可能代表球正向左飛,也可能正向右飛。模型要判斷球的移動方向,就需要一點時間資訊,而不是只看單張截圖。
因此,遊戲畫面會先轉成灰階並縮小,再把最近四張畫面放在一起交給模型。每次選好動作後,遊戲會向前更新數個畫面,模型再重新觀察。最後送進模型的資料是一疊小圖,而不是整段遊戲影片。
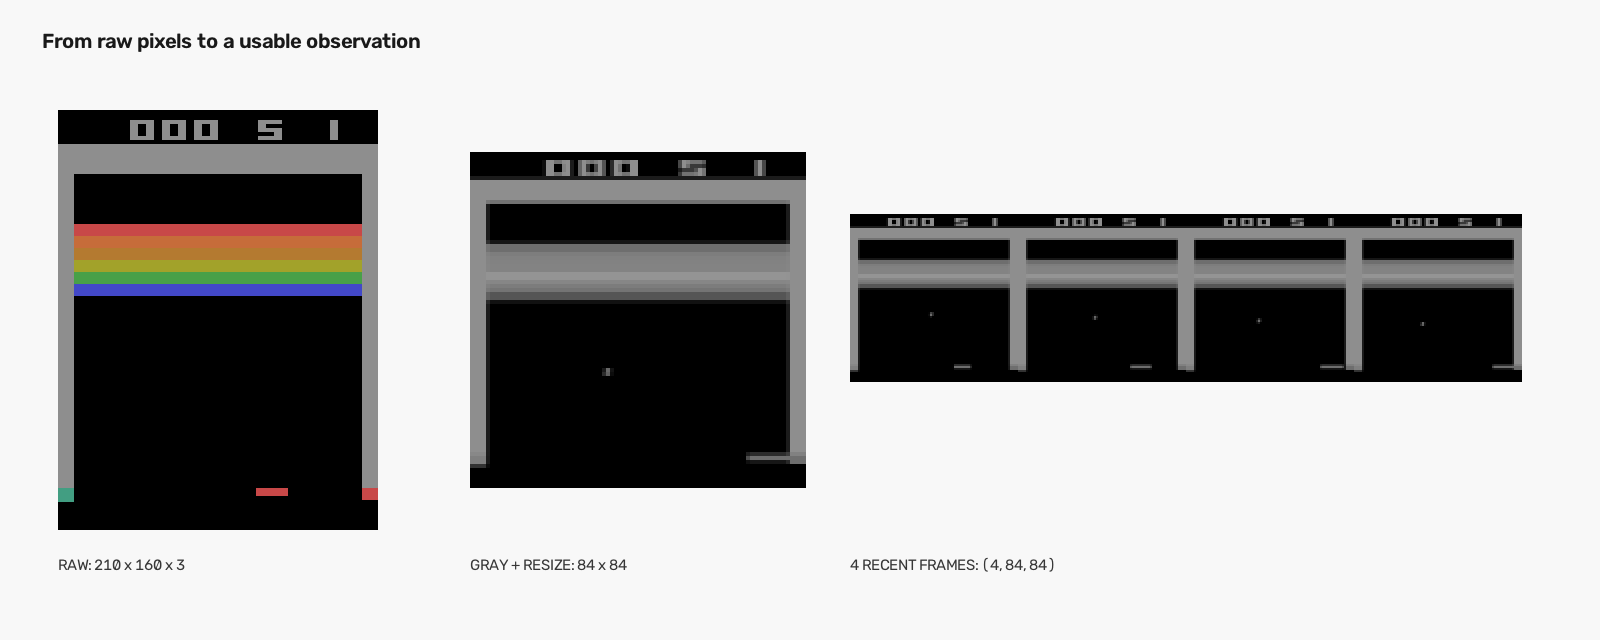
模型一次參考最近幾張畫面,因此能從畫面變化推測球的移動方向。
這樣整理能減少運算,也補上一點球的短期移動資訊;但它仍只是遊戲狀態的近似。模型不會因此看見人類玩家能理解的完整情境。
眼前沒得分,動作也可能是好的
假設球拍現在往右移,這一步沒有得分;但它可能正好移到球將要落下的位置。反過來說,這一步得了一分,也不代表它一定是最好的長期選擇。
模型因此不只看眼前的 reward,也會估計從現在開始,之後累積起來的分數。未來的回饋通常會比眼前的稍微打折計算:如果某個動作現在得 0 分,之後可能得到 3 分,折扣係數是 0.9,那麼往後兩步拿到的 3 分在今天看來約值 2.43 分。它可能比立刻拿到 1 分更值得。
這種「現在的回饋,加上折算後的未來價值」是強化學習反覆更新的核心。遊戲正常結束時,未來價值就不再延伸;若只是外部時間限制到達,則不能不加判斷地把未來價值清成零。
未來的分數怎麼傳回現在?
先看一個只有兩個畫面的簡化遊戲。從畫面 0 往右,當下拿不到分,但可以到畫面 1;再往右就能得到 1 分。若從任何一個畫面往左,遊戲都立刻結束。
學習剛開始時,模型不知道哪條路比較好。每當它走到右邊並取得分數,這個結果會先讓最後一步的價值增加;之後,前一步也會因為通往一個有價值的畫面而變得較值得選。
練習後,兩個畫面的估分會偏向同一條路:
畫面 0:往左 0.000000,往右 0.027720
畫面 1:往左 0.000000,往右 0.271000
選擇:畫面 0 往右,畫面 1 往右
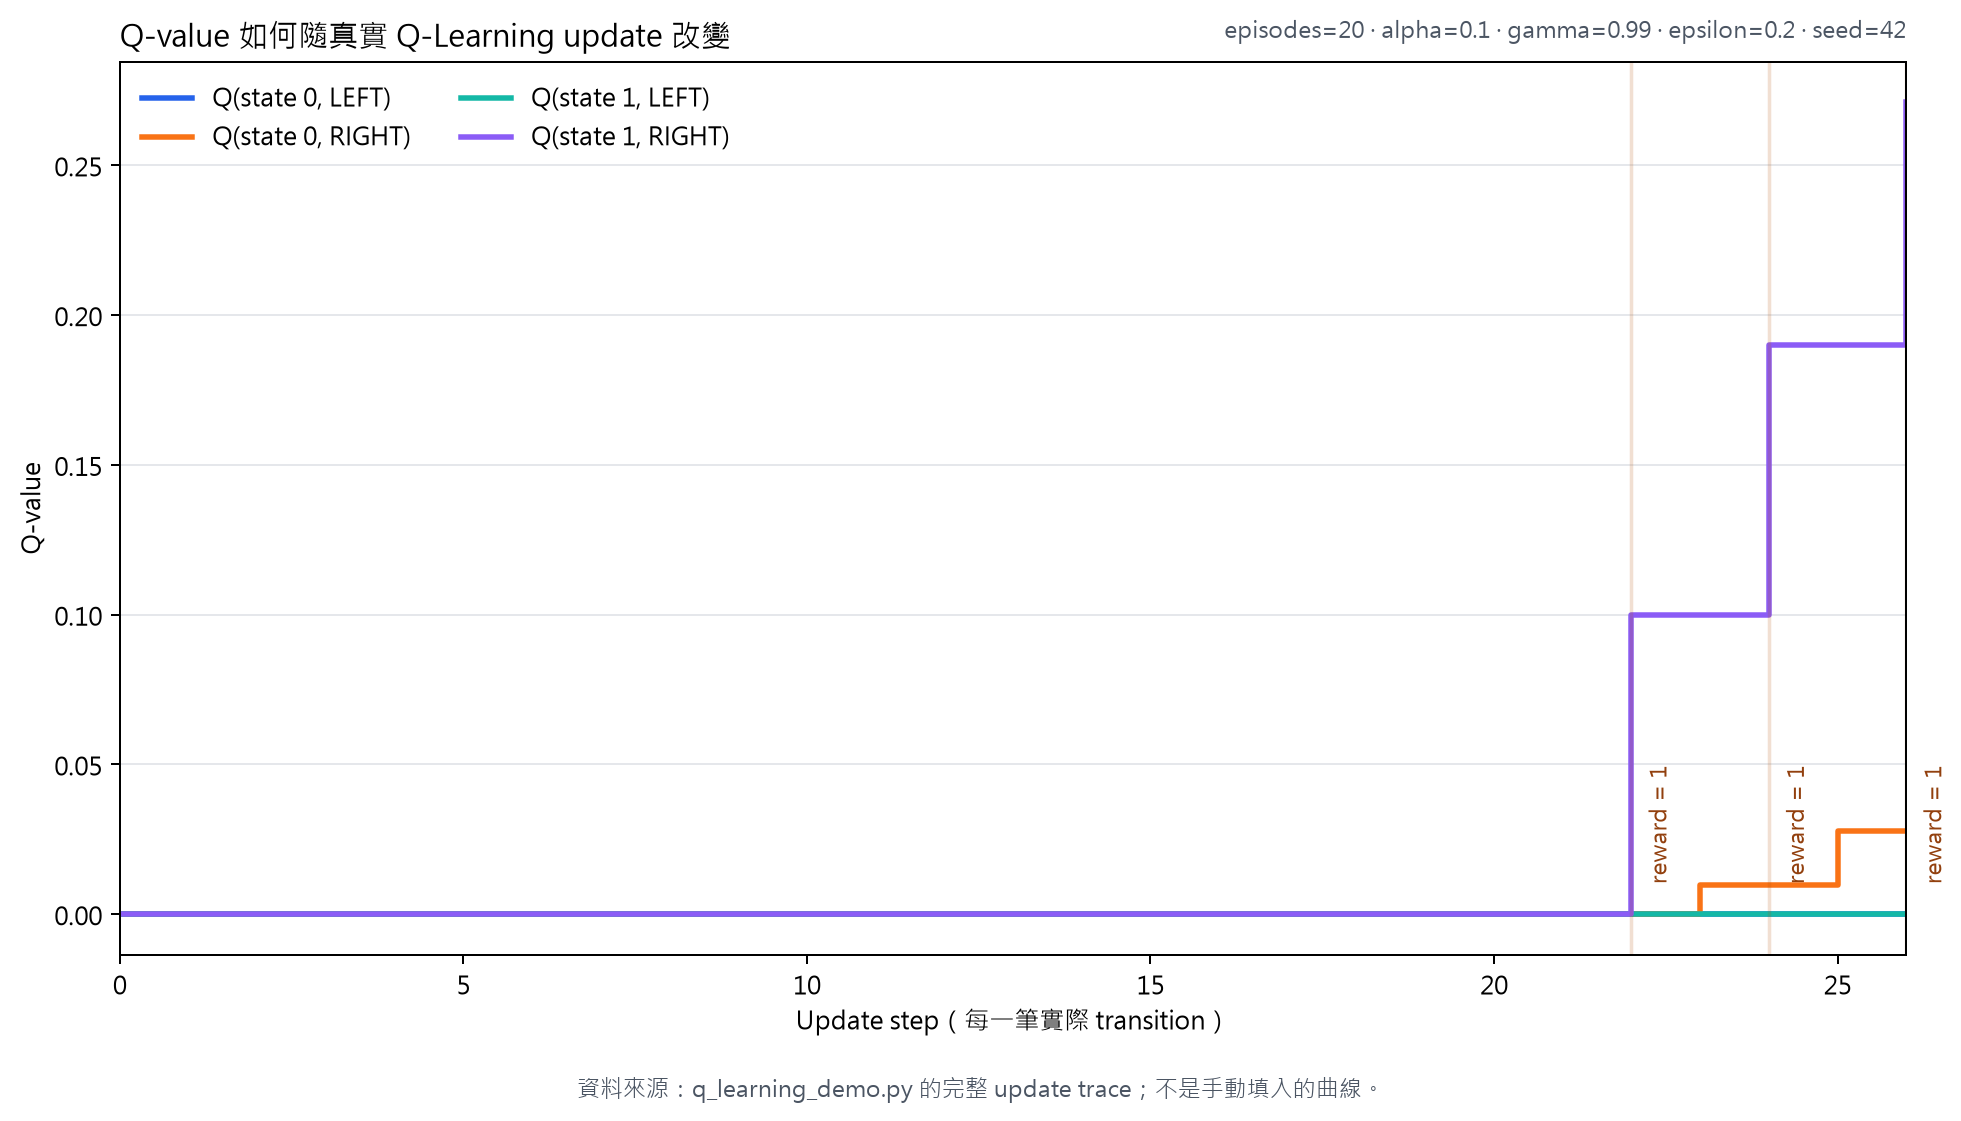
終點的分數先影響最後一步,再逐漸影響前面的選擇。
例如,畫面 0 往右後沒有立刻得分,但下一個畫面已經有估值 0.1。模型會先把這個未來估值乘上折扣,得到 0.099;再把原本的估分往目標移近一小步,於是從 0 更新到 0.0099。這次更新還沒讓它立刻拿分,卻開始讓它偏好那條通往分數的路。
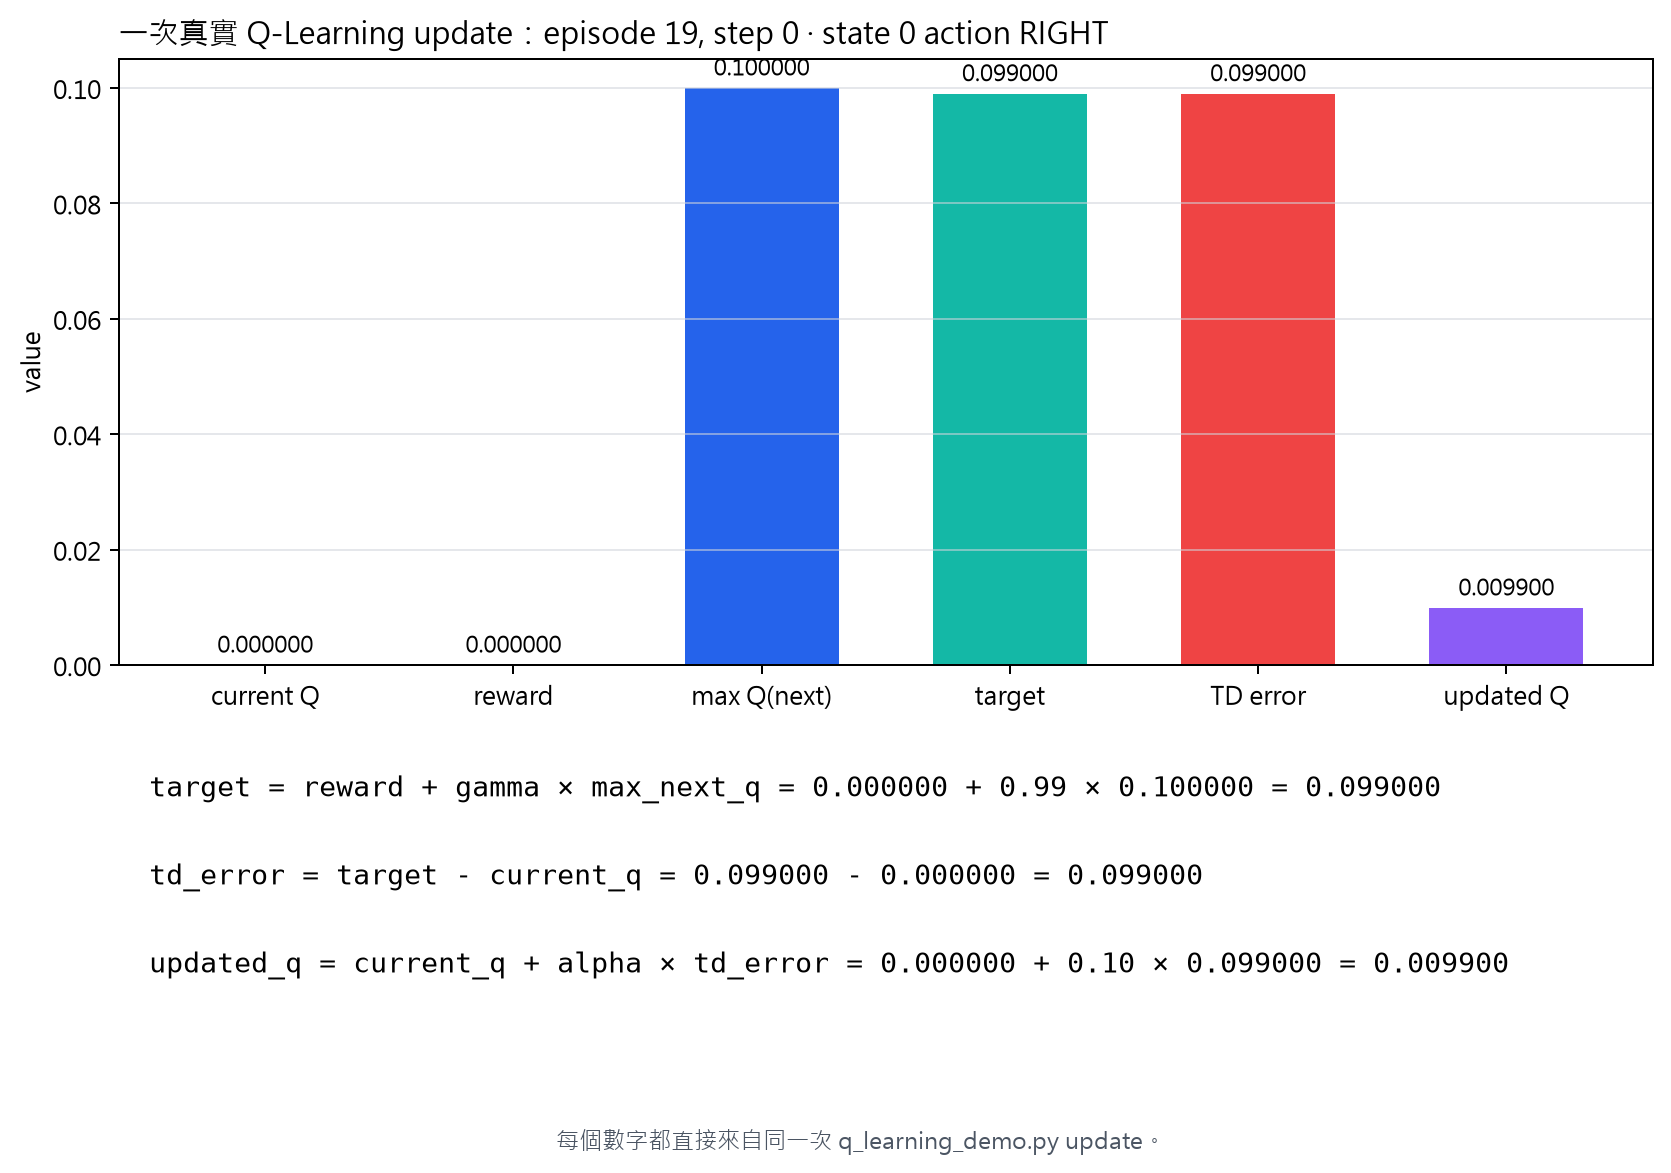
眼前得分是 0,仍可因為下一個畫面有價值而提高現在的估分。
為什麼還需要神經網路?
小型遊戲可以把每個畫面的估分放在表格裡。真實的 Breakout 卻有大量像素組合,很難替每個畫面各存一格。DQN 改用神經網路,從畫面中估計不同動作的未來價值,也讓相似畫面有機會共享學到的模式。
這回答的是模型如何處理畫面,還不是它是否已經玩得好。小型例子展示了未來回饋如何影響現在的估分;真正的 DQN 是否能把這種學習帶進 Breakout,還要看它實際遊戲時能否持續打出較好的結果。下一篇從訓練和除錯開始。