DQN 得分比較高,就代表真的會玩嗎?
一個 DQN 看似贏過隨機策略,逐局檢查卻發現它常卡在等待畫面。從這個反常結果理解訓練、除錯與公平評估。
文章目錄
早期測試裡,一個 DQN 平均拿到 4.53 分,隨機選動作的玩家只有 1.33 分。乍看之下,模型已經勝過隨機玩家;但查看每一局發生的事,結論就不那麼簡單了:15 局裡有 10 局不是正常結束,而是碰到時間上限才停下來。
逐步追查後,原因很具體。模型掉命後常常沒有按下發球鍵,遊戲停在等待畫面,它卻不斷把球拍往右移。平均分看起來較高,不能告訴我們模型究竟是在打球,還是在一個錯誤流程中耗時間。
模型如何把畫面變成選擇?
一張畫面難以看出球的移動方向,所以模型會同時參考最近幾張縮小後的灰階畫面。卷積神經網路會逐層整理畫面中的形狀與位置,再替不動、發球、往右和往左分別估計未來價值。模型最後選擇估值最高的動作;這只是它的預測,不是成功機率,也可能選錯。
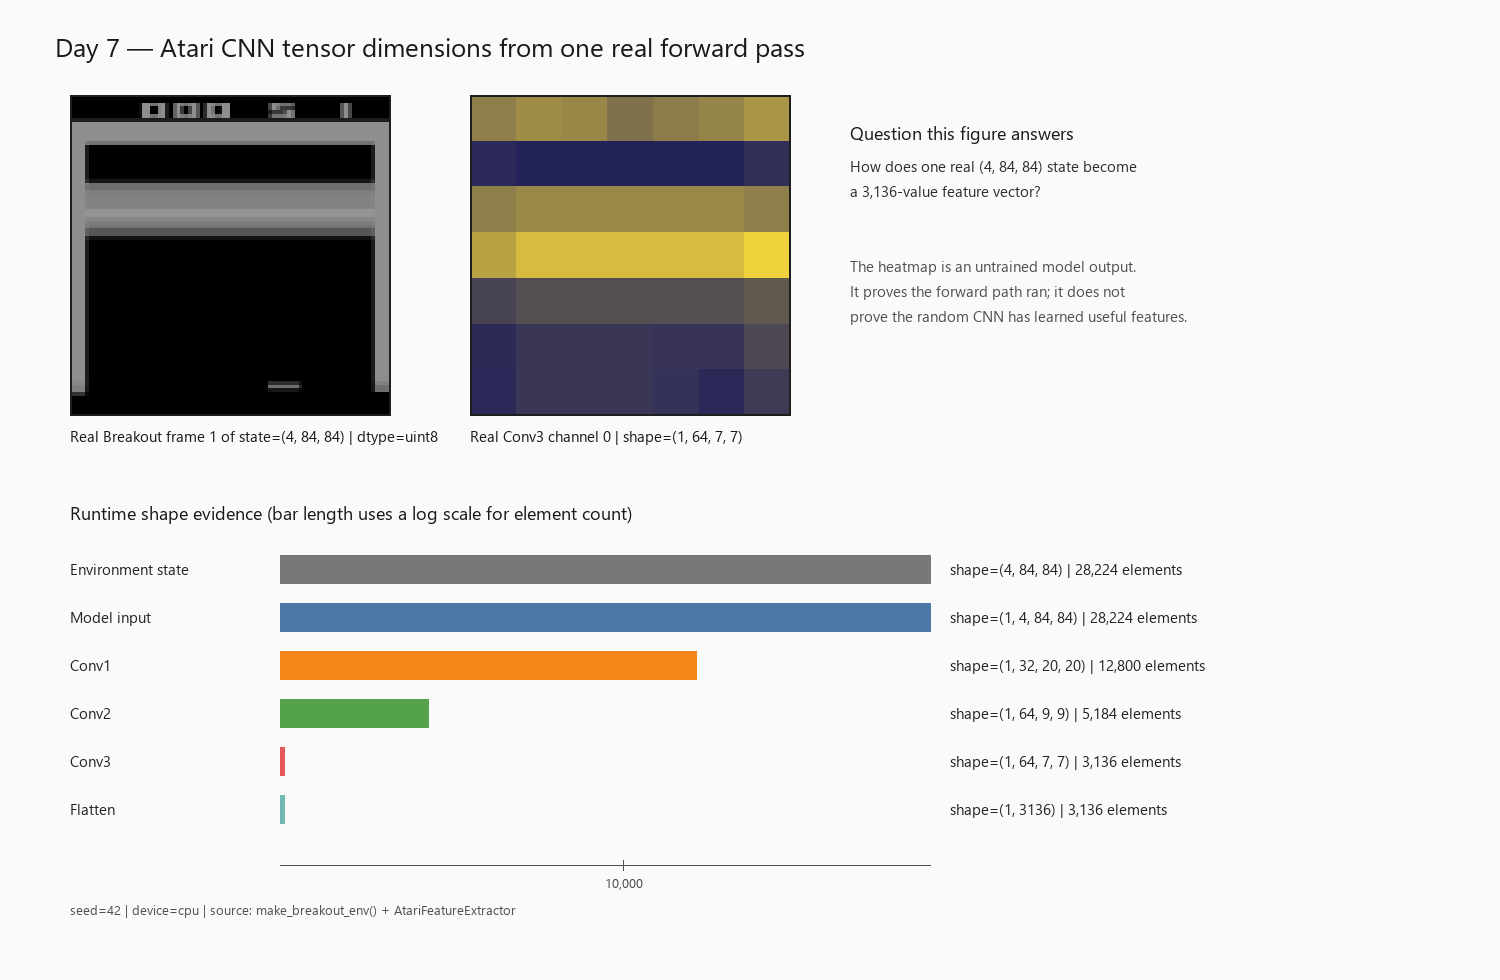
模型把連續畫面轉成較精簡的數值,再估計各種動作的價值。
模型需要從很多局的經驗學習。每次操作後,遊戲會留下「看到什麼、做了什麼、得幾分、接著看到什麼」的紀錄。訓練時不只重看剛發生的畫面,而會從過去紀錄中挑出一小批來練習,避免每次更新都只追著最新的一幕。
模型也不能永遠只做當下估分最高的動作,否則早期的錯誤猜測可能讓它困在同一種選擇裡。訓練會安排一些隨機嘗試,讓它有機會看到不同路線;隨著學習進行,再逐漸減少隨機動作。探索能帶來新經驗,但隨機遊玩得分高低本身不能證明模型已經學會。
訓練有在動,為什麼還不足以說它學會了?
更新模型時,程式會把目前的估分和一個暫時固定的參考估分比較。參考模型不會每一步都跟著改動,因此學習目標不至於在模型追趕時不斷移動。這就像先用一份暫時穩定的答案檢查猜測,再隔一段時間更新答案。
短程測試能檢查資料有沒有接通、模型能不能依照答案修正預測。它們回答的是「學習流程有沒有運作」,不是「這個模型已經會玩」。例如一次一千次操作的試跑只有四局,最多能讓人確認整段流程跑完,不能用四局的分數判斷穩定進步。
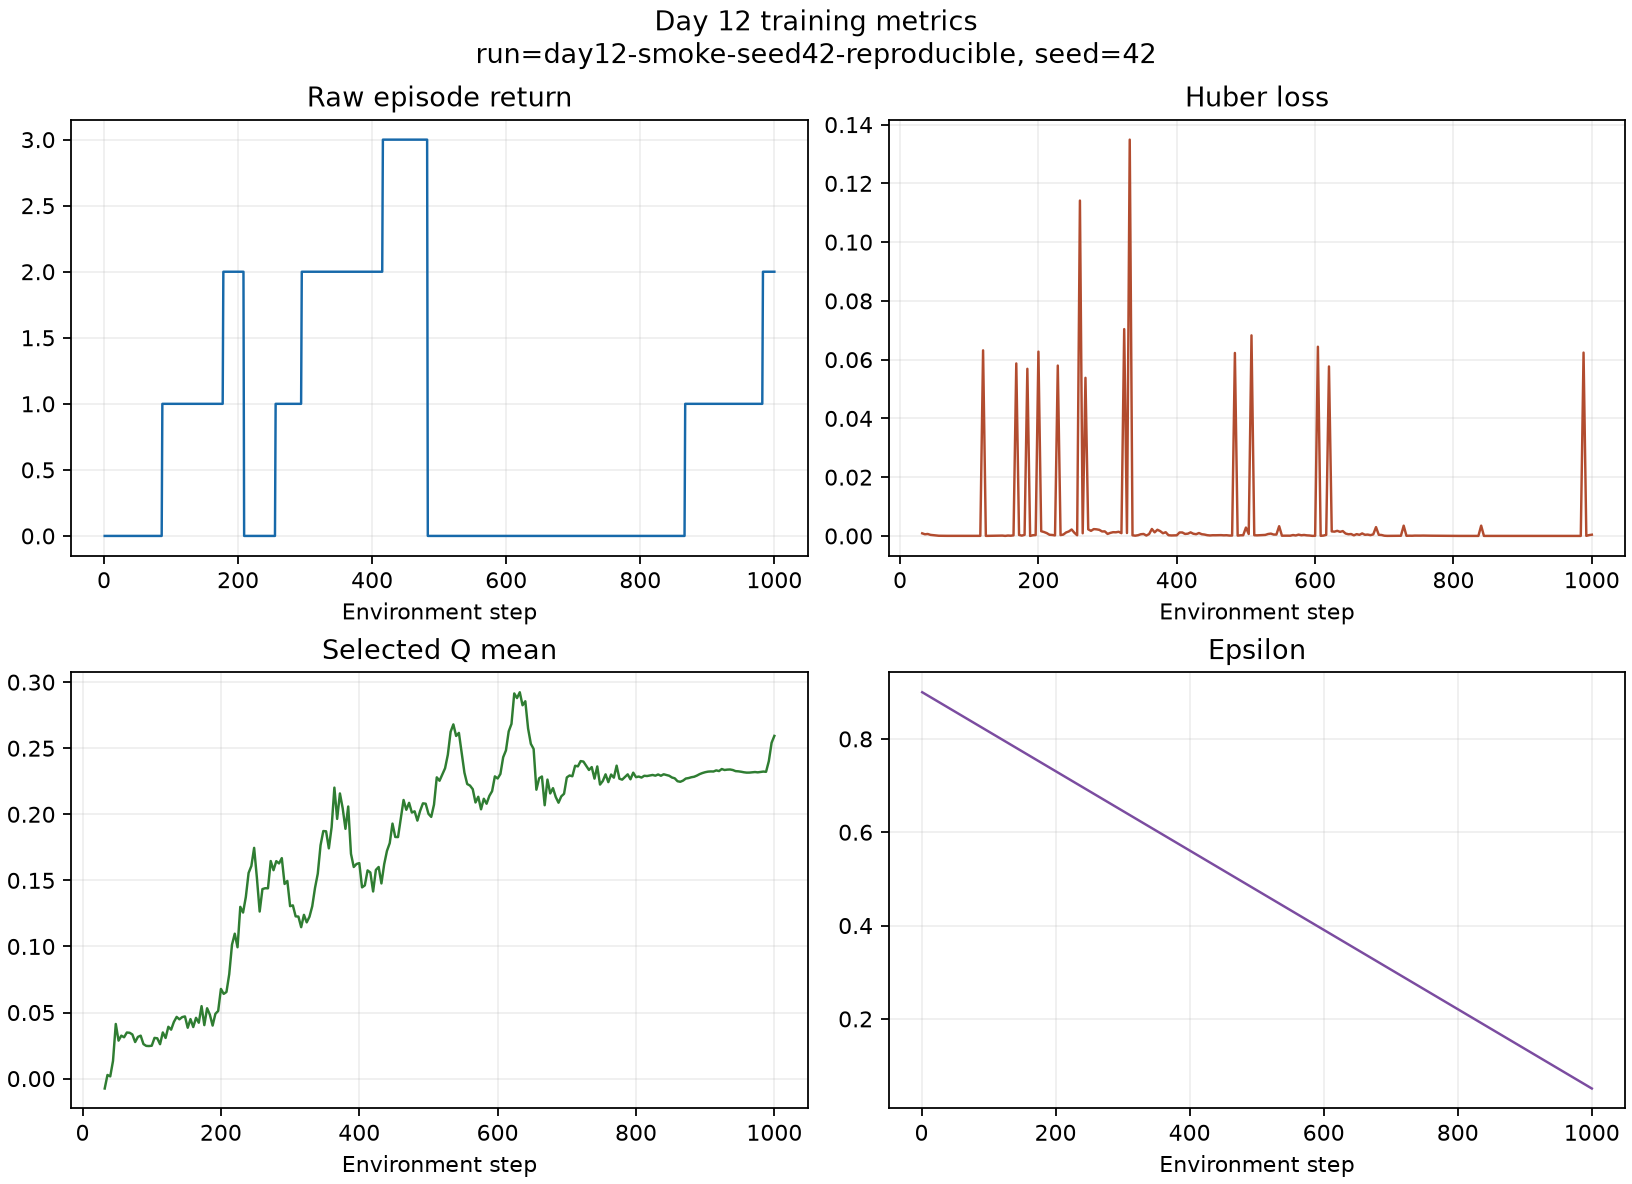
另一個除錯觀察會比較模型預測與學習目標的差距。如果差距持續暴增,代表訓練可能不穩;這次一萬次操作的試跑沒有看到這種失控訊號,但模型得分仍然很低。換句話說,模型確實在更新,不等於它已經學會有效擊球。
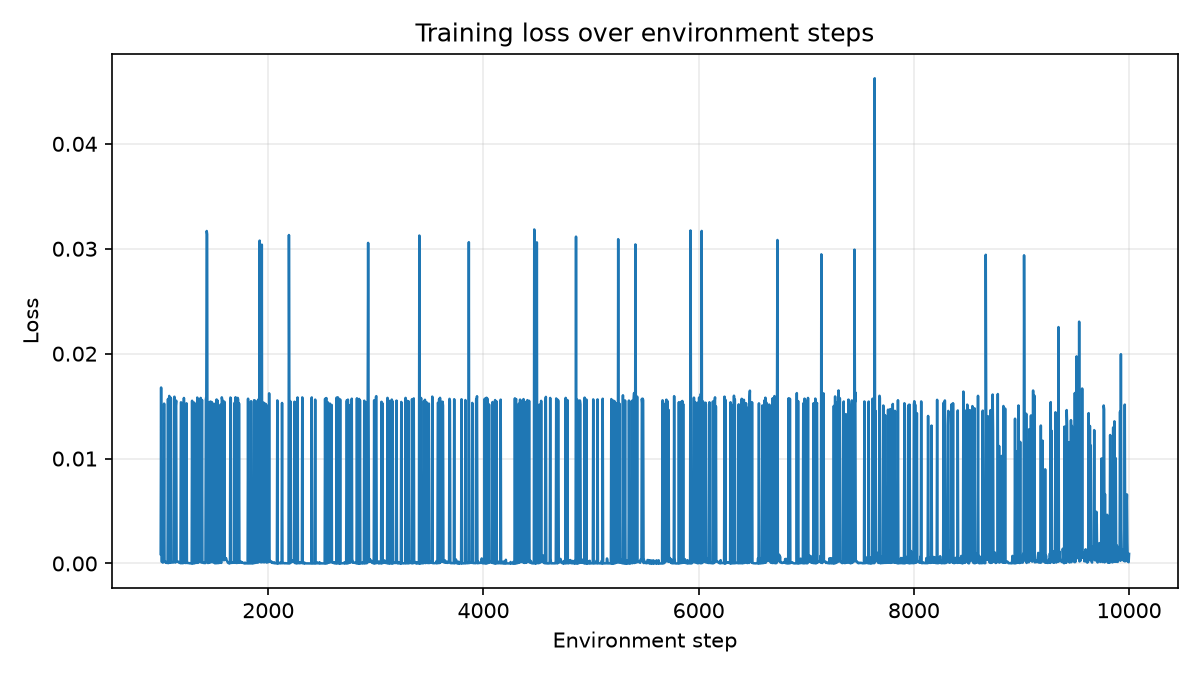
這條曲線用來檢查訓練訊號是否失控,不能單獨代表遊戲表現。
為什麼高分和長局數會誤導人?
原本的 15 局測試中,隨機策略都正常結束;DQN 卻有 10 局撞上操作上限。一次逐步檢查發現,模型掉命後等了 16,395 次操作才重新發球。等待期間,約 96% 的畫面幾乎沒有改變,動作也有約 96% 都是往右。
這像是一位玩家一直推著球拍,卻沒有重新把球打出去。若只看得分或遊戲持續時間,很容易把這種卡住的狀況誤認為策略比較好。
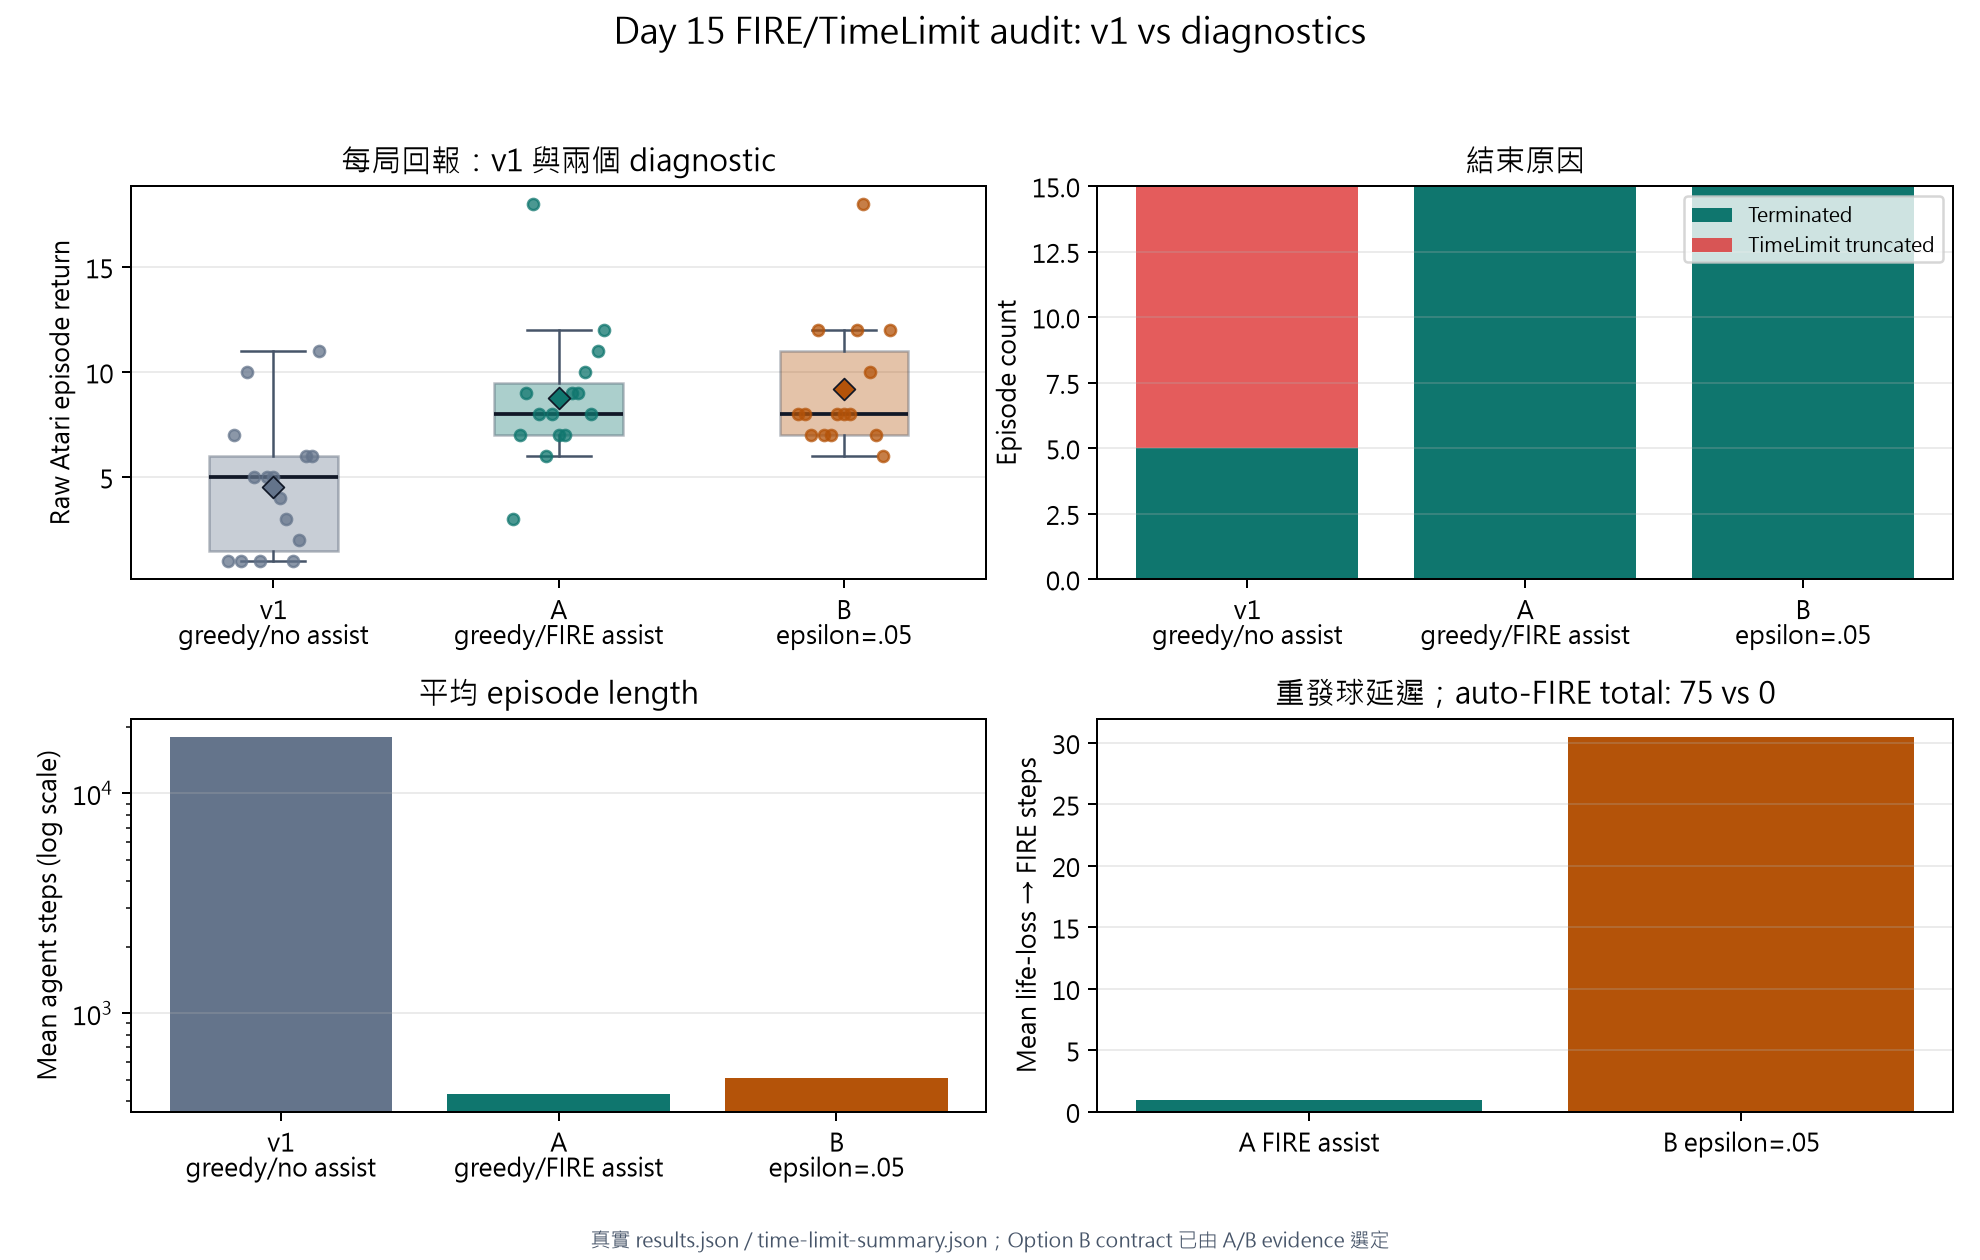
把發球流程修正後,DQN 在相同的 15 個起點都能正常結束。不過,自動發球和保留隨機動作會改變遊戲流程,因此修正前後的分數不能直接當成同一條件下的模型比較。真正的收穫是發現並修正了評估中的流程問題。
一次好結果,能選出最好的設定嗎?
另一個測試在同一個遊戲起點比較三種學習速度。較快更新的設定在最後幾局拿到較高分,值得繼續研究;但這只是一個訓練起點。強化學習每次訓練都會受到隨機經歷影響,單次結果不足以確定哪個設定普遍最好。
因此,公平比較要固定遊戲規則、測試起點和訓練長度,並用不同訓練重做比較。測試同一個已訓練模型很多局,可以看它遇到不同局面時的起伏;重新訓練多次,才知道這個改動能不能在不同學習過程中重現。
怎麼判斷模型真的進步?
這次除錯的關鍵,不是找到一個最高分,而是把三個問題分開:資料有沒有正確送進模型?模型有沒有照目標更新?更新後的策略,在正常遊戲中是否比對照方法穩定?
只有前兩個答案是「有」,仍不足以說模型會玩。評估時還要檢查每局怎麼結束、動作是否真的推動遊戲,以及不同起點是否有相似表現。接下來可以再問:更快的訓練或不同的 DQN,會不會帶來可重現的進步?下一篇會比較訓練速度和模型版本。