模型換了執行方式,DQN 還會做出相同選擇嗎?
把訓練好的打磚塊模型交給另一種執行環境前,先確認它面對相同畫面時還會做出相同選擇,再比較速度與代價。
文章目錄
訓練好的 DQN 可以放進另一個執行環境,讓它不必依賴原本訓練模型的程式。轉換成另一種格式後,檔案能成功載入,只表示新的執行環境看得懂它;更重要的是,它面對相同畫面時,還會不會選同一個動作?
這個差別在打磚塊裡尤其明顯。模型會替不動、發球、往右、往左估分,選出最高的一個。只要其中一次選擇改變,之後看到的遊戲畫面也可能跟著不同。
換一種方式執行,模型會改變嗎?
ONNX 是一種可讓不同軟體讀取模型的格式。ONNX Runtime 則負責實際計算。對讀者來說,可以把它想成同一份食譜交給另一個廚房:紙張讀得懂,不代表做出來的菜就一定相同。
最直接的檢查,是把完全相同的 60 張遊戲畫面交給原本的 PyTorch 模型和兩種 ONNX Runtime 執行方式,再看它們選了什麼動作。這批畫面上,三種方式的選擇全都一致,數值最大差距約 0.000162。這只說明它們在這批畫面上的行為相同,不能保證未見過的每一張畫面都完全一致。
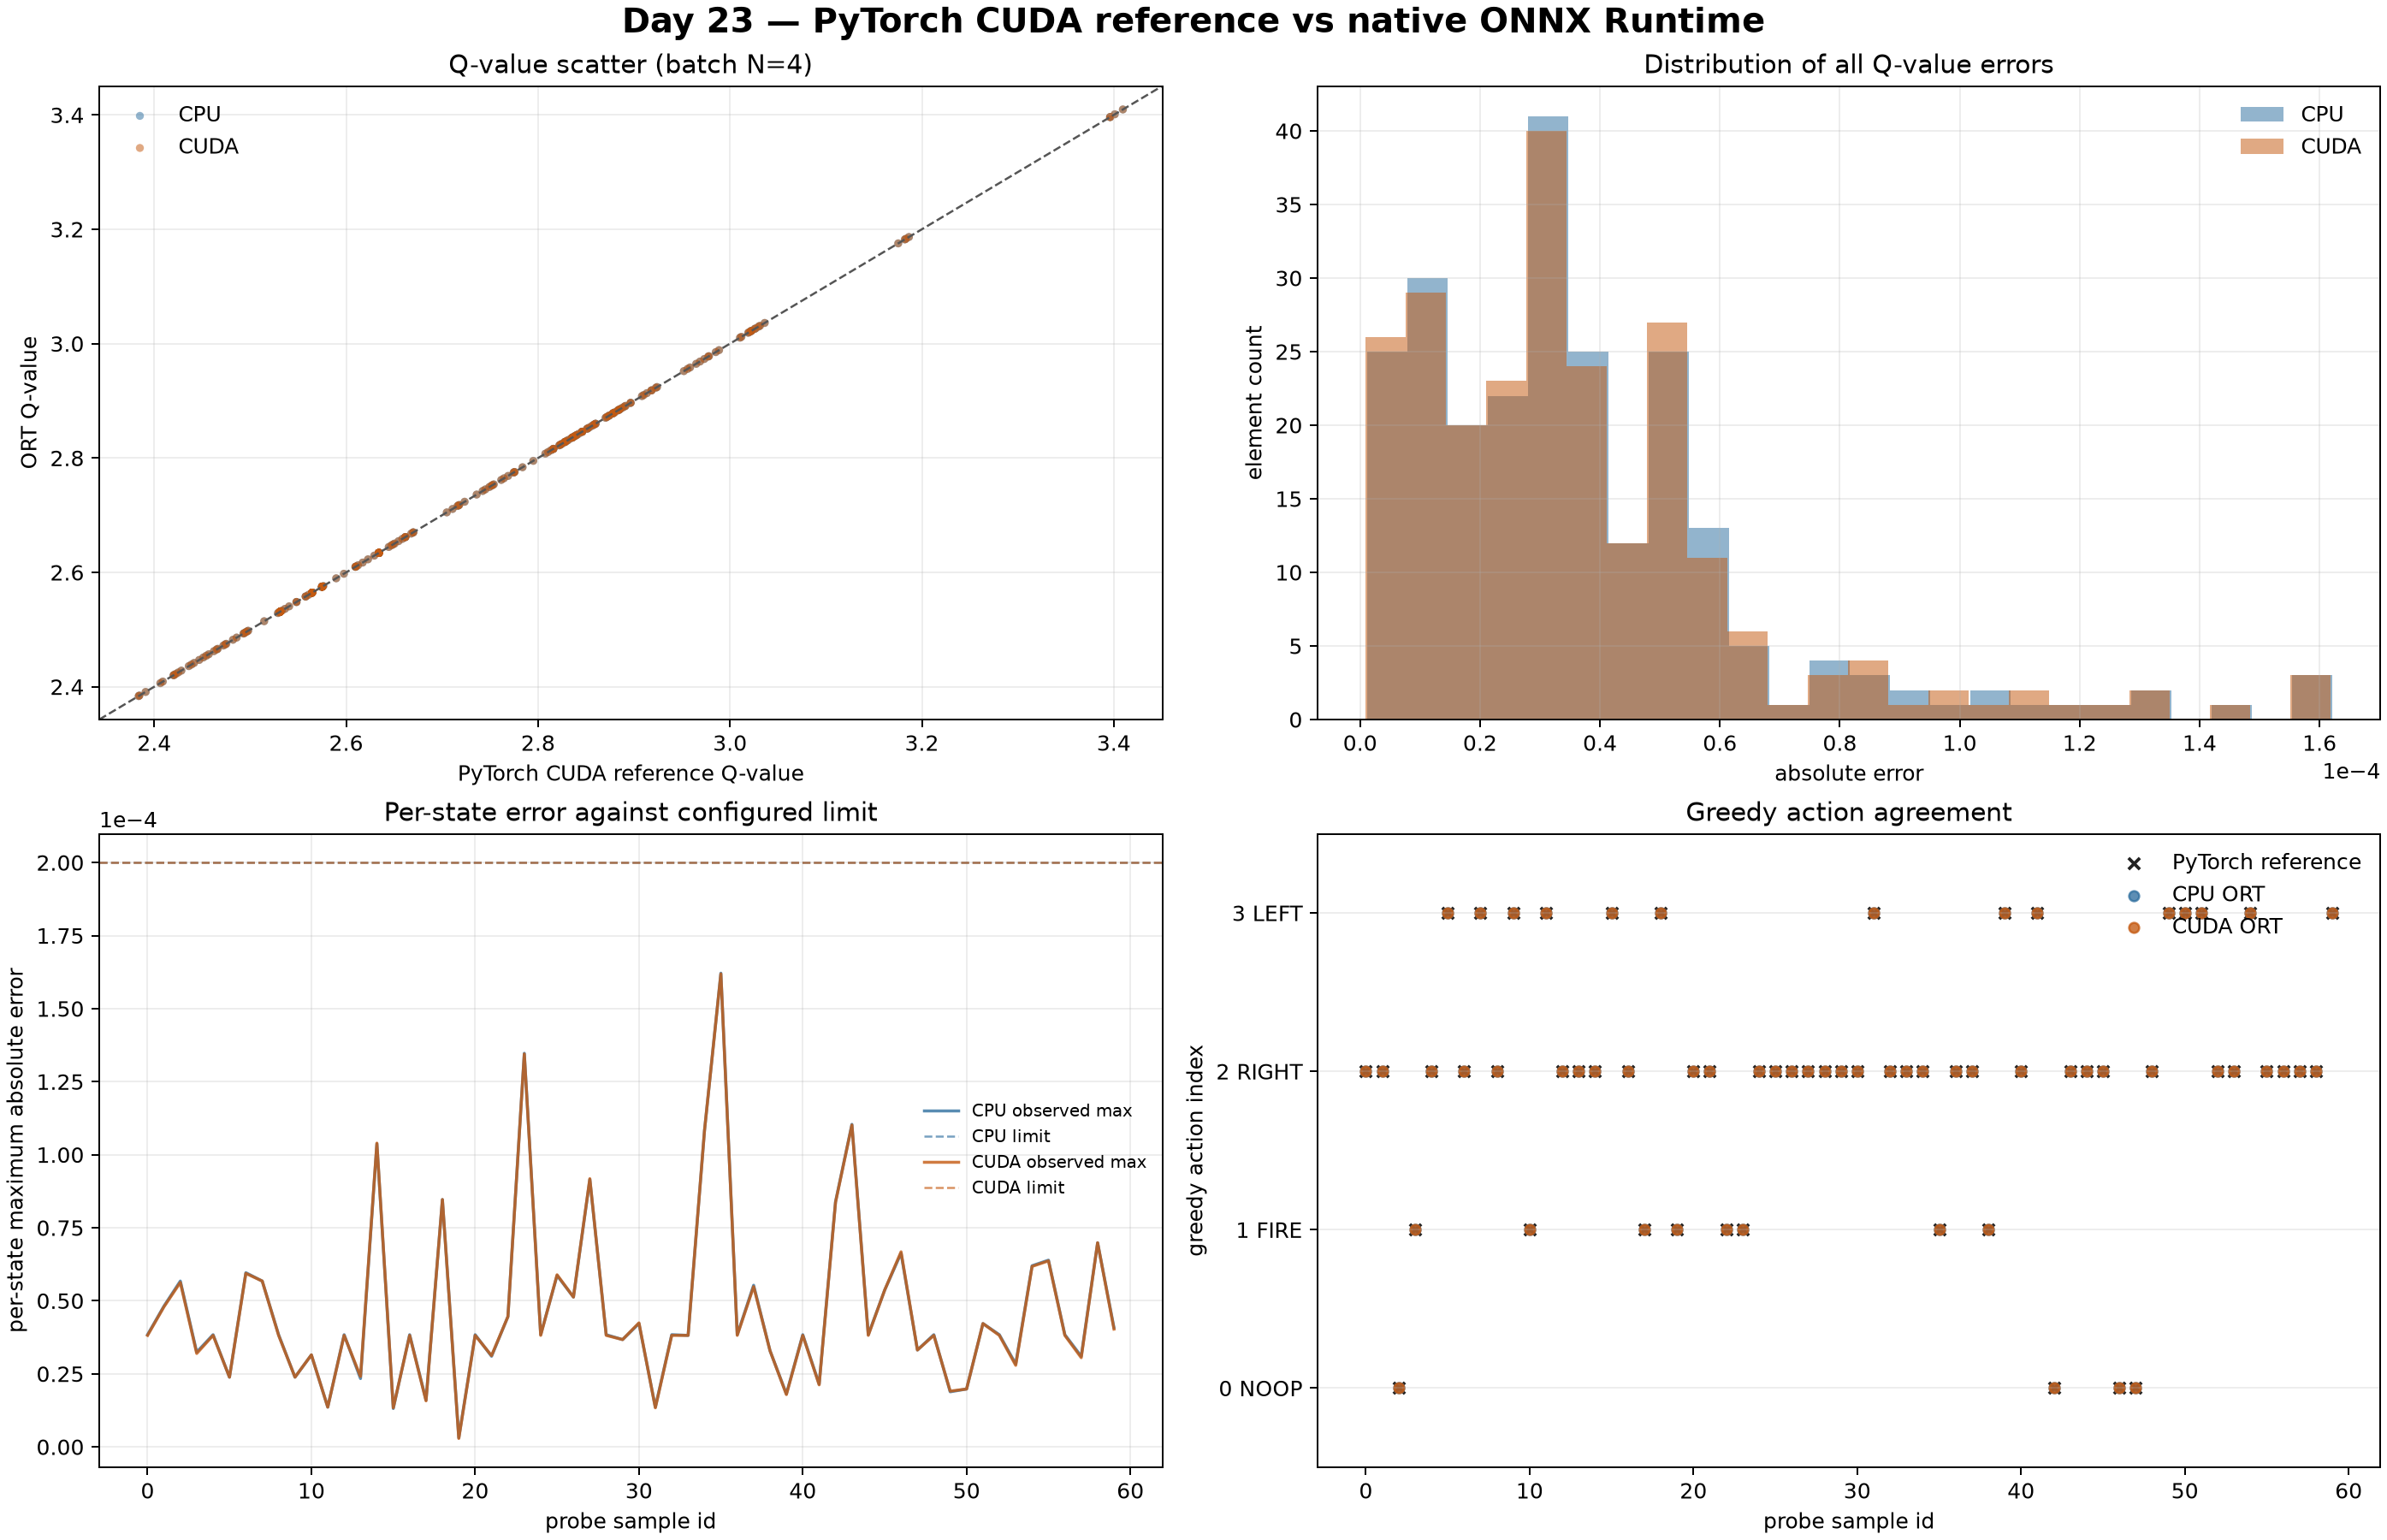
模型輸出的分數有細微差異,但這批畫面中最高分的動作沒有改變。
怎麼量到一次選擇真正花的時間?
打磚塊一次只需要模型處理眼前的一組畫面,因此測試一次決策,而不是同時塞進大量資料。先讓模型執行幾次以完成啟動,再重複量測。P50 是一半的測量結果比它快、一半比它慢;P95 則顯示比較慢的那一端大約要等多久。
| 執行方式 | 一般耗時(P50) | 較慢時(P95) |
|---|---|---|
| PyTorch CPU | 2.533 ms | 3.298 ms |
| PyTorch GPU | 1.526 ms | 2.862 ms |
| ONNX Runtime CPU | 0.856 ms | 1.596 ms |
| ONNX Runtime GPU | 1.342 ms | 2.663 ms |
這個小模型每次只處理一組畫面,所以 ONNX Runtime CPU 反而比 GPU 快。GPU 除了計算,還要付出搬資料和啟動的時間;對較小的工作,這些額外時間可能比省下的計算還多。這是這台電腦和這個模型的結果,不能解讀成 CPU 一定比 GPU 快。
把模型縮小,為什麼動作會變?
把模型數字從較高精度改成較低精度,可以讓檔案大小幾乎減半。但數值變化也會影響模型對動作的估分,尤其當兩個動作原本就很接近時,最後選擇可能翻轉。
同樣的 60 張畫面裡,較低精度的模型有 4 次選了不同動作;模型檔案縮小約一半,但這輪測量沒有更快,反而較慢。對這個打磚塊模型而言,縮小檔案沒有換到預期的速度收益,卻改變了一部分決策,因此沒有採用。
更快之外,還要看整局遊戲
另一種專為 NVIDIA 顯示卡設計的執行方式,在這台筆記型電腦上把較慢端的延遲從 1.110 毫秒降到 0.761 毫秒,改善約 31%。固定畫面的選擇也都與原本模型一致。
不過,固定畫面仍不能看出一個細微差異會不會一路影響後續遊戲。於是三種執行方式又從相同的 30 個遊戲起點開始測試:
| 執行方式 | 30 局平均分 |
|---|---|
| PyTorch,原本精度 | 42.53 |
| ONNX Runtime,原本精度 | 42.03 |
| 專用 GPU 執行方式,原本精度 | 42.03 |
| 專用 GPU 執行方式,較低精度 | 36.80 |
原本精度的專用 GPU 執行方式,和 ONNX Runtime 在這 30 個起點上的每局分數完全相同;較低精度的平均分較低,但這批局數還不足以斷定它一定會降低表現。速度結果因此只支持一個有限結論:在這個模型、這台設備和這些測試條件下,原本精度的專用 GPU 執行方式值得使用。
模型換了執行環境後,要先確認選擇是否仍然合理,再看等待時間,最後用多場遊戲檢查結果。下一個問題是:若把它放進瀏覽器,瀏覽器產生的遊戲畫面和動作是否也能對得上?